AI 도구를 고를 때 모델 이름만 봐서는 차이를 알기 어렵다. 작업 중 얼마나 쉽게 꺼내 쓸 수 있는지, 응답을 기다리는 동안 무엇을 할 수 있는지, 계속 사용했을 때 비용은 어떤지도 중요하다. 이번에는 데스크톱 앱부터 음성 대화, API 최적화, 로컬 모델까지 살펴본다.
1. Windows용 Gemini - 작업하던 화면에서 바로 부르는 AI
Google은 9월 10일 Windows용 Gemini 앱을 출시했다. Windows 10과 11을 대상으로 전 세계에 제공되며, Alt + Space를 누르면 작업 중인 화면 위로 Gemini를 열 수 있다.
문서를 쓰다가 요약을 부탁하거나 발표 자료 제목을 떠올리는 식으로 사용할 수 있다. 앱 안에서는 Gmail과 Google Drive의 정보를 활용한 작업, 이미지·영상 생성, 개인 에이전트 Gemini Spark도 연결된다. 다만 Spark와 Gemini Omni는 Google AI 구독이 필요하고, 제공 범위가 다르며 18세 이상을 대상으로 한다.
여기서 눈여겨볼 부분은 새 모델보다 AI를 부르는 위치다. 브라우저 탭을 찾아가 질문하는 과정이 줄면 문서 작성이나 자료 정리 중간에 AI를 끼워 넣기 쉬워진다. 앱 출시가 곧 모든 PC 프로그램의 자동 조작을 뜻하는 것은 아니며, Google은 추가 네이티브 기능을 순차적으로 제공할 계획이라고 밝혔다.
출처: Google - Windows용 Gemini 출시 (9월 10일)
2. GPT-Live 1 - 검색을 기다리면서도 대화를 이어간다
OpenAI는 9월 10일 GPT-Live 1을 API에서 정식 제공하기 시작했다. 핵심은 말하면서 동시에 들을 수 있는 풀 듀플렉스(full duplex)와, 음성 대화와 실제 작업을 서로 다른 부분에 맡기는 구조다.
GPT-Live가 사용자와 대화하는 동안 백엔드 모델이나 에이전트는 정보를 찾고 도구를 실행한다. 예를 들어 주문 상태를 조회하는 중에도 사용자가 주문 번호를 덧붙이거나 질문을 바꿀 수 있다. 개발자는 음성 모델과 별개로 작업을 담당할 백엔드를 선택한다.
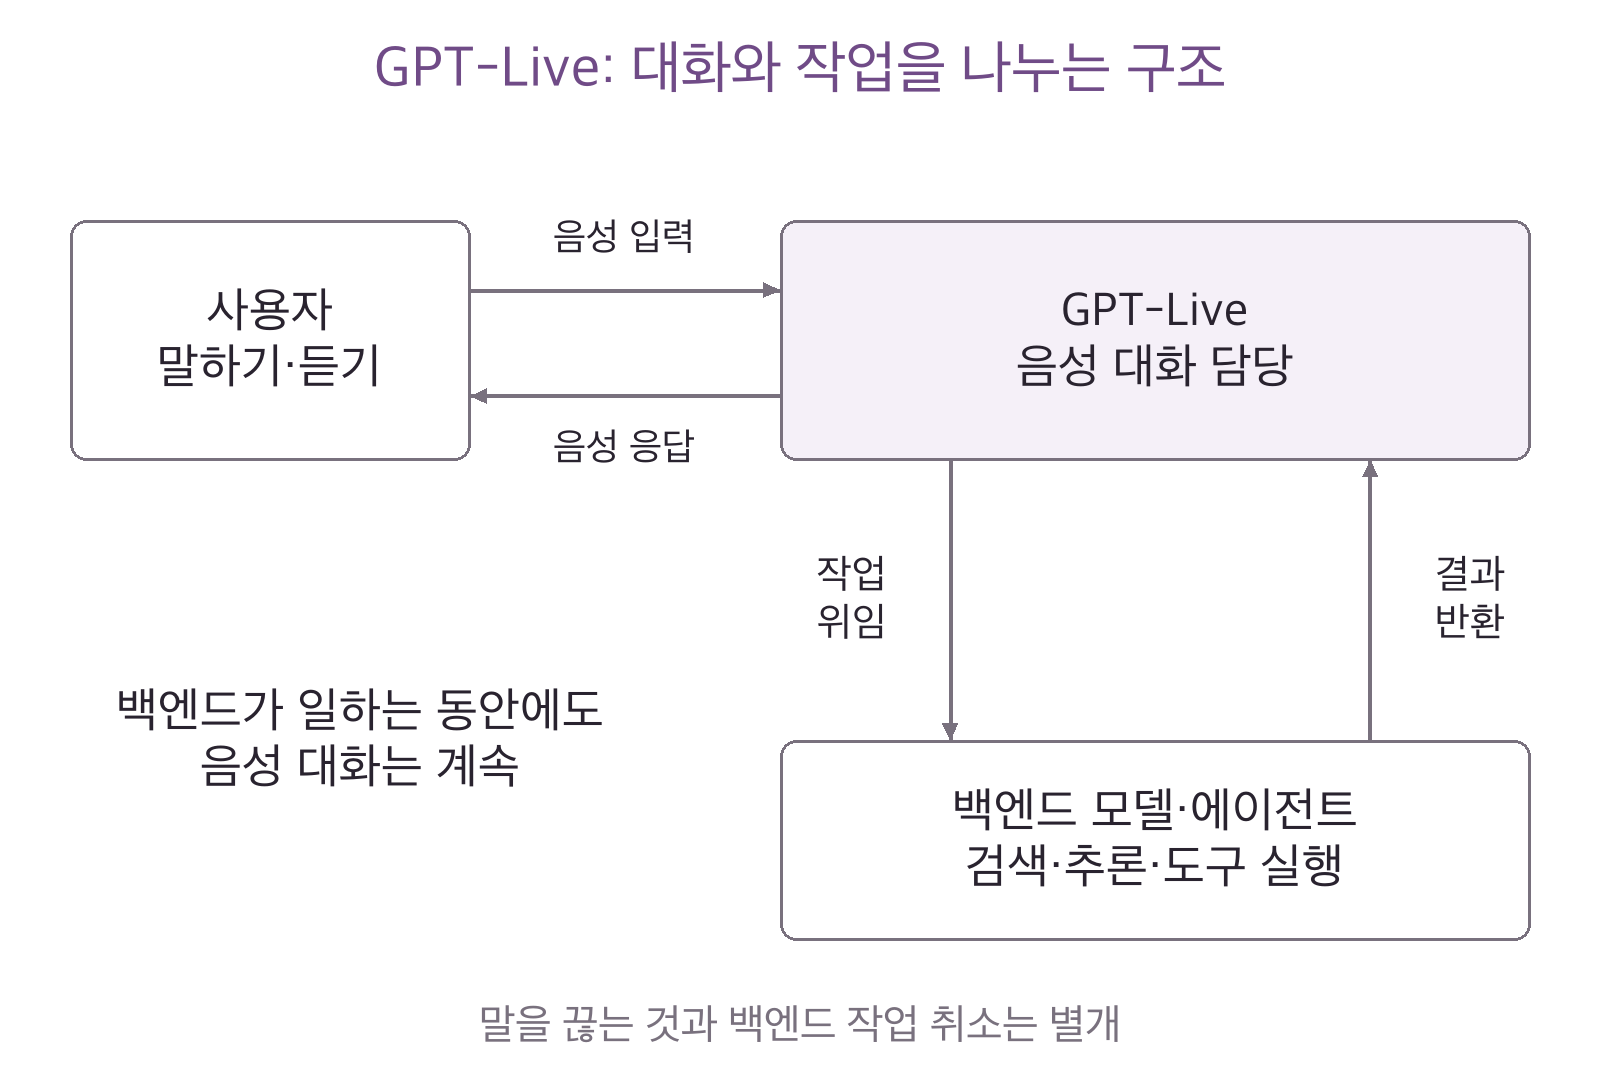
대화는 계속하면서 검색과 도구 실행을 백엔드에 맡기는 구조.
이 구조가 흥미로운 이유는 음성 AI의 사용감을 답변 속도 하나로 설명하기 어렵기 때문이다. 긴 작업이 진행 중일 때 추가 정보를 받고, 중간 상황을 설명하고, 결과가 준비되면 알려주는 흐름을 만들 수 있다.
구현할 때는 음성을 끊는 행동이 백엔드 작업까지 자동 취소하지는 않는다는 점을 주의해야 한다. 예약이나 파일 변경 같은 작업의 취소·승인은 애플리케이션에서 따로 처리해야 한다. 음성 세션 요금은 분당 0.05달러이며 초 단위로 청구되고, 백엔드 모델과 도구 사용료는 별도다.
출처: OpenAI API 변경 기록 (9월 10일), GPT-Live 공식 문서
3. Prompt Cache Diagnostics - 캐시가 왜 빗나갔는지 확인한다
OpenAI는 9월 8일 Prompt Cache Diagnostics를 정식 제공했다. Responses API의 GPT-5.6 및 이후 지원 모델에서 사용할 수 있다. 이름 그대로 예상보다 프롬프트 캐시를 적게 재사용한 이유를 확인하는 기능이다.
캐시는 비슷한 질문의 답변을 그대로 복사하는 기능이 아니다. 요청 앞부분에 반복되는 지침이나 문맥을 재사용해 입력 처리 부담을 줄이는 방식이다. 재사용에는 앞부분의 정확한 일치와 모델·도구 등 요청 설정의 호환성이 필요하다.
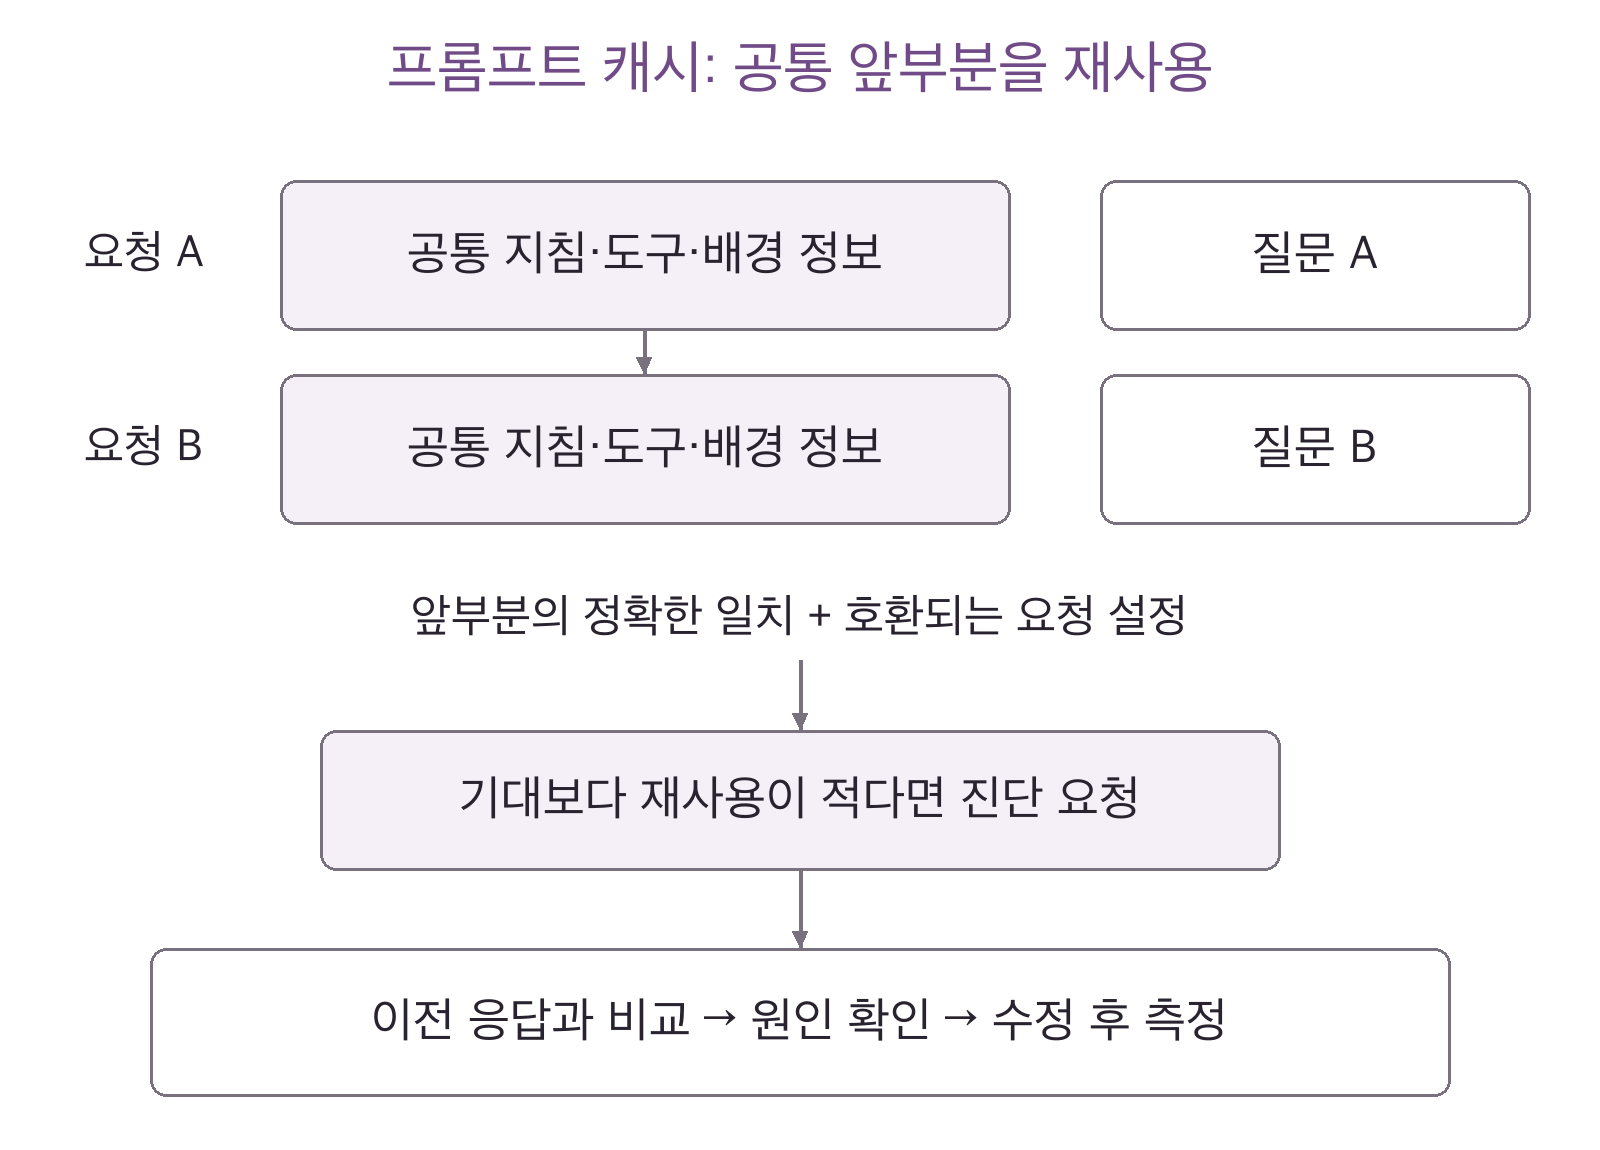
질문이 달라도 공통 앞부분은 재사용 대상이 될 수 있다.
비교 기준이 되는 이전 응답의 ID를 prompt_cache_options.comparison_response_id에 넣으면 현재 응답의 prompt_cache_diagnostics에서 진단 결과를 확인할 수 있다. 실제 재사용량은 usage.input_tokens_details.cached_tokens로 살핀다.
예를 들어 같은 내용을 보냈더라도 도구 정의나 순서가 바뀌면 재사용을 방해할 수 있다. 진단용 ID는 이전 대화를 불러오거나 캐시 사용을 강제하는 설정이 아니다. 비교해서 원인을 찾는 용도다.
API로 반복 작업을 만드는 입장에서는 더 작은 모델로 바꾸기 전에 확인할 만하다. 고정 지침과 도구 구성이 요청마다 불필요하게 바뀌고 있지는 않은지 살펴보고, 수정 전후의 재사용량과 지연 시간을 함께 재면 된다.
출처: OpenAI API 변경 기록 (9월 8일), Prompt Cache Diagnostics 공식 문서
4. 로컬 AI 양자화 - 같은 4비트라도 내부 구성이 다르다
클라우드 서비스 밖에서는 모델을 내 장비에 맞게 줄이는 작업도 이어지고 있다. GGUF 모델을 배포하는 Bartowski는 9월 10일 Hugging Face 커뮤니티 글에서 텐서별 양자화 배치를 개선하는 실험을 공개했다. Hugging Face 전체의 새 표준이 아니라 배포자의 자체 기법이다.
양자화는 모델의 수치를 더 적은 비트로 표현해 저장 공간과 메모리 부담을 줄이는 기술이다. 그런데 모델 내부의 모든 텐서가 정밀도를 줄였을 때 똑같이 영향을 받지는 않는다. 이번 접근은 민감한 부분에 비트를 더 배정하고, 정해진 크기 안에서 손실을 줄이려는 방식이다.
Bartowski는 텐서 하나씩 정밀도를 낮춰 영향을 측정하고, 그 결과를 바탕으로 배치표를 만드는 방법을 설명했다. 새로운 모델 구조에는 기존 방식과 비교하는 검사를 두고, 결과가 좋지 않으면 기존 방식으로 되돌린다.
로컬 모델을 고르는 사용자에게는 파일 이름의 Q4·Q5만 보지 말고 실제 파일 크기와 배포 설명도 확인하자는 이야기로 이어진다. 같은 이름이라도 내부 배치와 크기가 바뀔 수 있다. 이번 평가는 WikiText에서 원본과의 출력 확률 차이를 측정한 것이므로, 한국어 대화나 코드 작성 성능까지 그대로 보장하는 결과는 아니다.
출처: Bartowski - Per-tensor layout maps for GGUF quantization (9월 10일)
5. Lyria 3.5 - 음악 생성도 제작 도구 안으로
Google은 9월 4일 음악 생성 모델 Lyria 3.5를 Gemini 앱과 Gemini API에서 제공한다고 발표했다. 앱에서 장르를 고르거나 설명하고, 보컬곡과 연주곡을 선택할 수 있다. 템플릿과 짧은 곡·긴 곡 선택 기능도 소개했다.
Google은 보컬 표현과 편곡, 음질이 개선됐다고 설명한다. Gemini 웹·모바일 외에도 Flow Music, Google AI Studio, Google Vids에서 활용할 수 있어 음악 생성의 접점이 넓어졌다.
게임이나 영상 작업에서는 원하는 분위기의 음악을 빠르게 구체화하는 용도가 떠오른다. 예를 들어 차분한 탐험 장면과 긴장감 있는 전투 장면의 시안을 따로 만들어 방향을 비교하는 식이다. 실제 게임에 넣을 때는 처음 들었을 때의 인상 외에도 반복 재생 연결부와 효과음·대사를 가리지 않는지까지 확인해야 한다.
출처: Google - Lyria 3.5 in Gemini (9월 4일)
이번에 챙겨둘 포인트
이 소식들을 보면 AI의 변화가 답변 품질에만 있지는 않다는 생각이 든다. 데스크톱에서는 접근하는 과정이 짧아지고, 음성에서는 대화와 작업이 동시에 진행된다. 개발 쪽에서는 같은 기능을 더 적은 비용과 메모리로 돌리기 위한 도구가 세밀해지고 있다.
- 일반 사용: 자주 하는 문서 정리나 자료 찾기에서 앱 전환이 얼마나 줄어드는지 본다.
- API 개발: 응답 속도뿐 아니라 캐시 재사용량, 작업 취소 처리, 전체 비용을 확인한다.
- 로컬 모델: 양자화 이름만 비교하지 않고 같은 장비·질문으로 메모리와 결과를 함께 살핀다.
- 창작: 생성된 한 장면이나 한 곡이 실제 제작 흐름에 들어갈 때 필요한 수정까지 생각한다.
새 도구를 전부 써볼 필요는 없다. 지금 자주 막히는 작업 하나를 골라, 그 과정이 얼마나 편해지는지부터 확인하면 트렌드가 훨씬 구체적으로 보인다.
'기타 > AI 정보 정리' 카테고리의 다른 글
| AI 정보 정리 (2026.09.17) - Claude 채팅·Cowork 통합, 무엇이 달라지나 (0) | 2026.09.17 |
|---|---|
| AI 정보 정리 (2026.09.13) - 대답하는 AI에서 일을 맡는 AI로 (0) | 2026.09.13 |

